Visão geral do projeto
- Projeto
- Estudo de caso de UX
- Função
- Senior UX Designer
- Duração
- Fase de discovery
- Status
- Trabalho real, com detalhes sensíveis e identificáveis removidos
- Contexto
- Projeto real, anonimizado (NovaFlow é um nome fictício no lugar da empresa real)
Contexto
NovaFlow é uma plataforma fictícia usada para acompanhar a demanda de ciclos de produção recorrentes, comparando o que é necessário com o que de fato está disponível. Todo item precisa estar pronto antes de começar o ciclo de produção que depende dele. Como a maioria das plataformas que já existem há algum tempo, o conhecimento sobre ela estava espalhado: documentação antiga do sistema, regras de negócio que ninguém tinha escrito, pesquisas perdidas nas anotações de alguém, conclusões de reuniões que nunca foram registradas em lugar nenhum. A cada nova funcionalidade, o discovery começava do zero, com pessoas refazendo perguntas já respondidas e cavando de novo um contexto que já existia em algum lugar.
A necessidade ficou clara quando chegou o pedido de uma funcionalidade potencialmente grande, que exigiria atenção de verdade e não podia começar de uma página em branco. Usei esse pedido como motivo para definir como uma base de conhecimento deveria ser organizada e como um documento de discovery deveria ser estruturado. Depois testei essa estrutura no próprio pedido, fazendo-a consultar toda a documentação atual e a base de conhecimento recém-organizada. Liderei esse trabalho, e o time do projeto, com Devs, QAs e UXs, revisou tudo ao longo do caminho, para que o resultado refletisse como o time inteiro trabalhava de verdade, e não só a minha visão.
Eu queria resolver isso deixando o discovery mais rápido, para que ninguém precisasse reconstruir um contexto que já existia.
A abordagem foi simples: colocar tudo em um único repositório Git, para que a base de conhecimento e cada documento de discovery ficassem juntos, versionados e fáceis de acompanhar ao longo do tempo.
Definindo a base de conhecimento
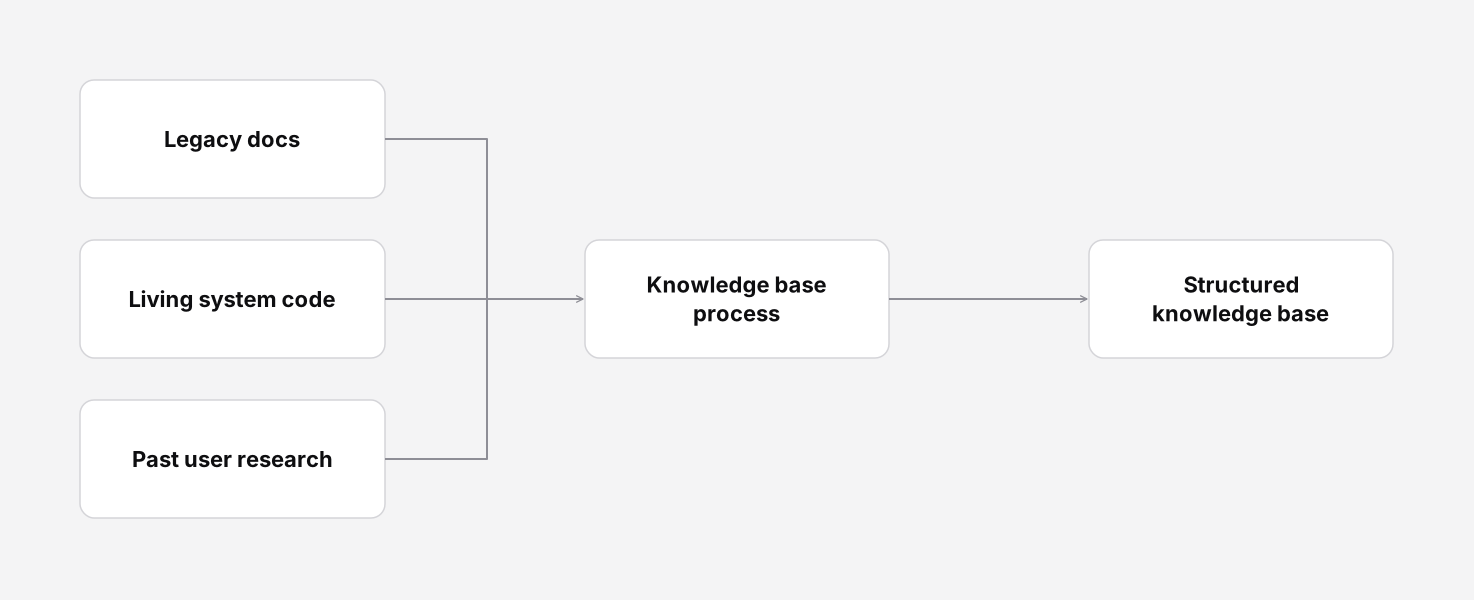
O primeiro passo foi descobrir como pegar toda aquela documentação espalhada, junto com o próprio código do sistema em uso, e transformá-la em uma base de conhecimento única, organizada e estruturada. Em vez de depender só de documentos que podiam estar desatualizados, o processo usou o código real para confirmar como as coisas funcionavam de fato hoje.
Trabalhando módulo por módulo, mapeamos a documentação que já existia, comparamos com o que o código realmente fazia e versionamos a base de conhecimento, para que ela pudesse ser atualizada conforme as coisas mudassem, em vez de ser escrita uma vez e ficar obsoleta. Tudo foi estruturado de forma consistente para poder ser reutilizado com confiança depois. Uma ferramenta de IA cuidou da ingestão, mas o trabalho de verdade foi definir o que “organizado” significava: o que registrar, como estruturar e como manter atualizado. Liderei essa definição, e o time revisou conforme ela tomava forma.
O resultado é uma base de conhecimento viva, que pode ser atualizada conforme os sistemas e as pesquisas evoluem, em vez de uma página de wiki que ninguém mais abre.
Definindo o template de discovery
Com a base de conhecimento pronta, o próximo passo foi definir como um documento de discovery deveria ser: quais perguntas ele precisa responder, em que ordem e com quais evidências. Esse template é a principal entrega aqui, porque é ele que transforma um contexto espalhado em algo utilizável.
Com o template definido, uma ferramenta de IA conseguia consultar a base de conhecimento e gerar automaticamente uma primeira versão para um novo pedido de funcionalidade. Em vez de começar de uma página em branco e correr atrás manualmente do estado atual, dos stakeholders e das restrições, o rascunho já chegava apoiado em um contexto real e com fontes. Isso liberou tempo para validar com o time e fechar lacunas, em vez de repetir a mesma pesquisa várias vezes. Liderei o design do template, e o time revisou cada rascunho gerado.
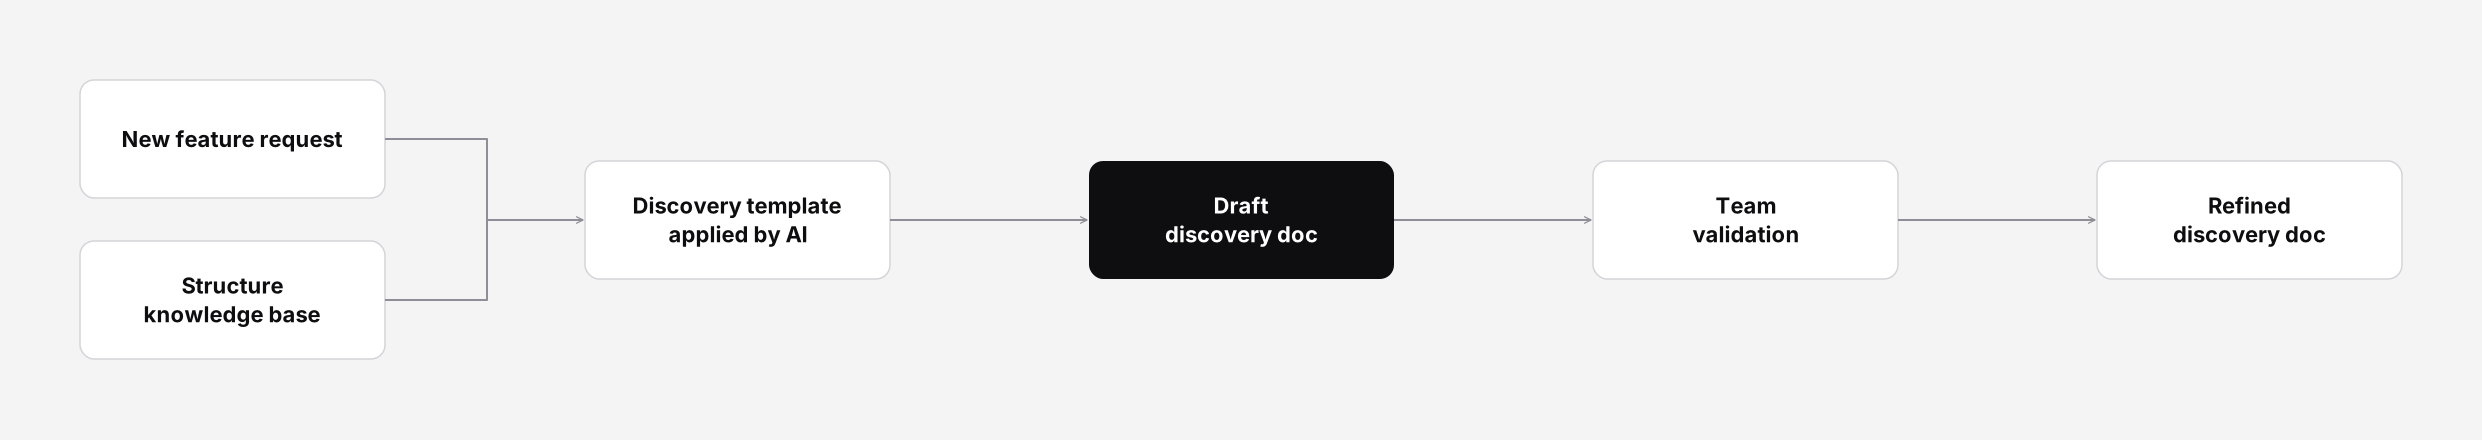
Estrutura do documento de discovery
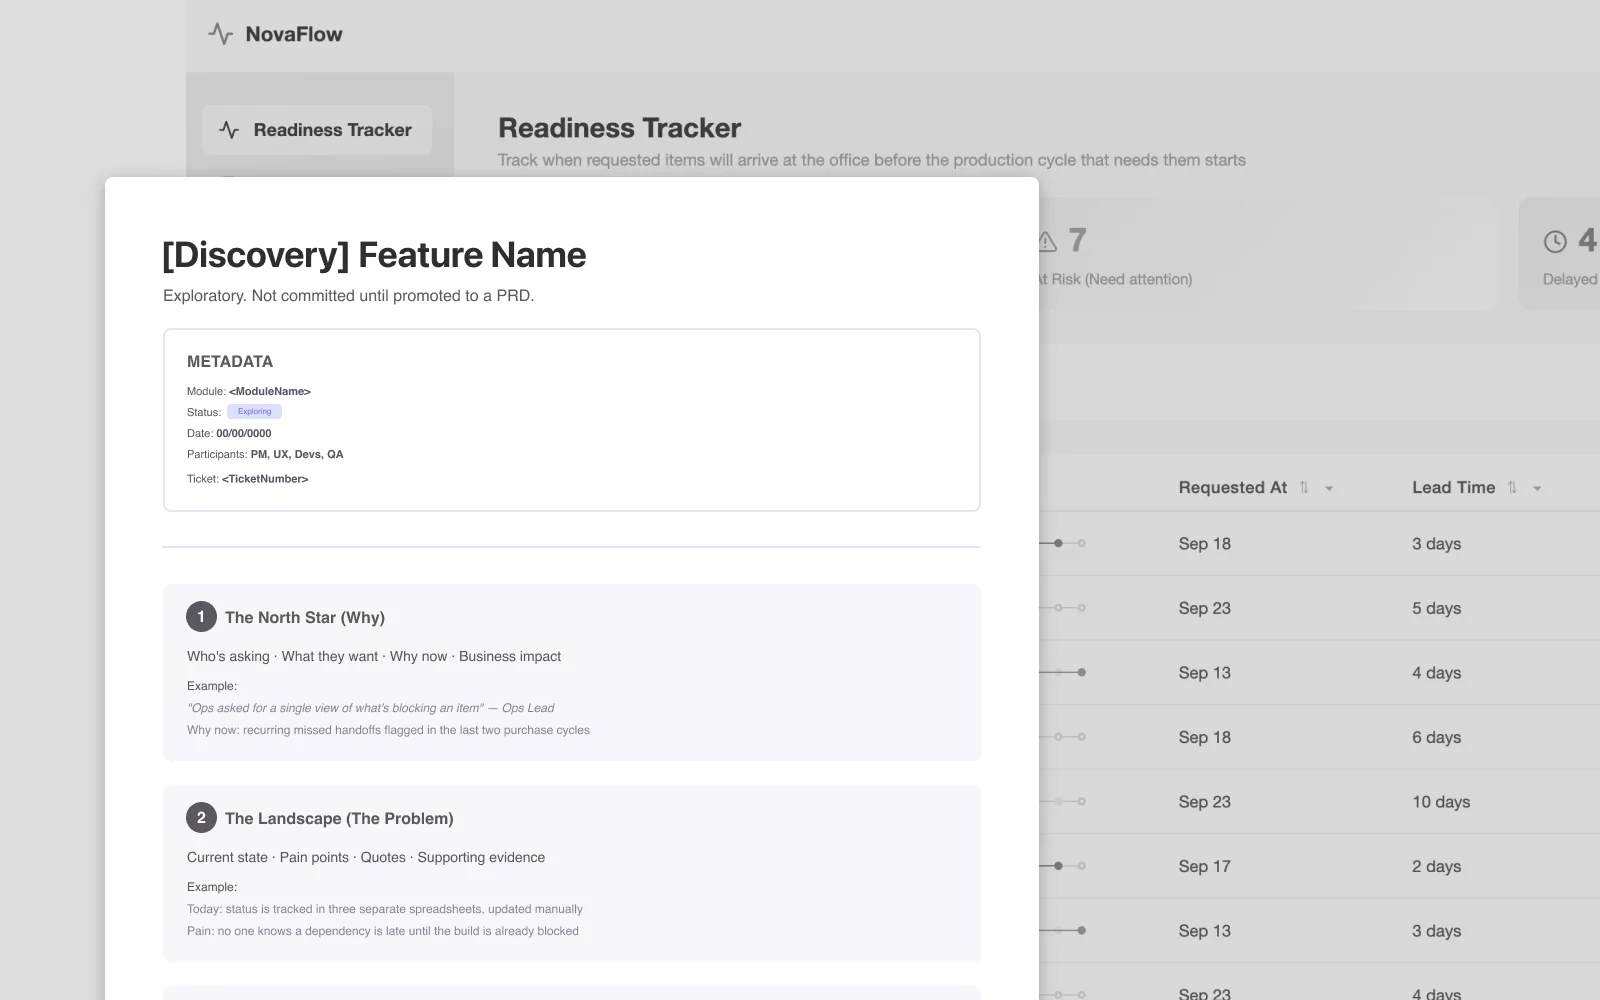
Todo documento segue a mesma estrutura, pensada para ser lida como uma única história, do porquê até os próximos passos.
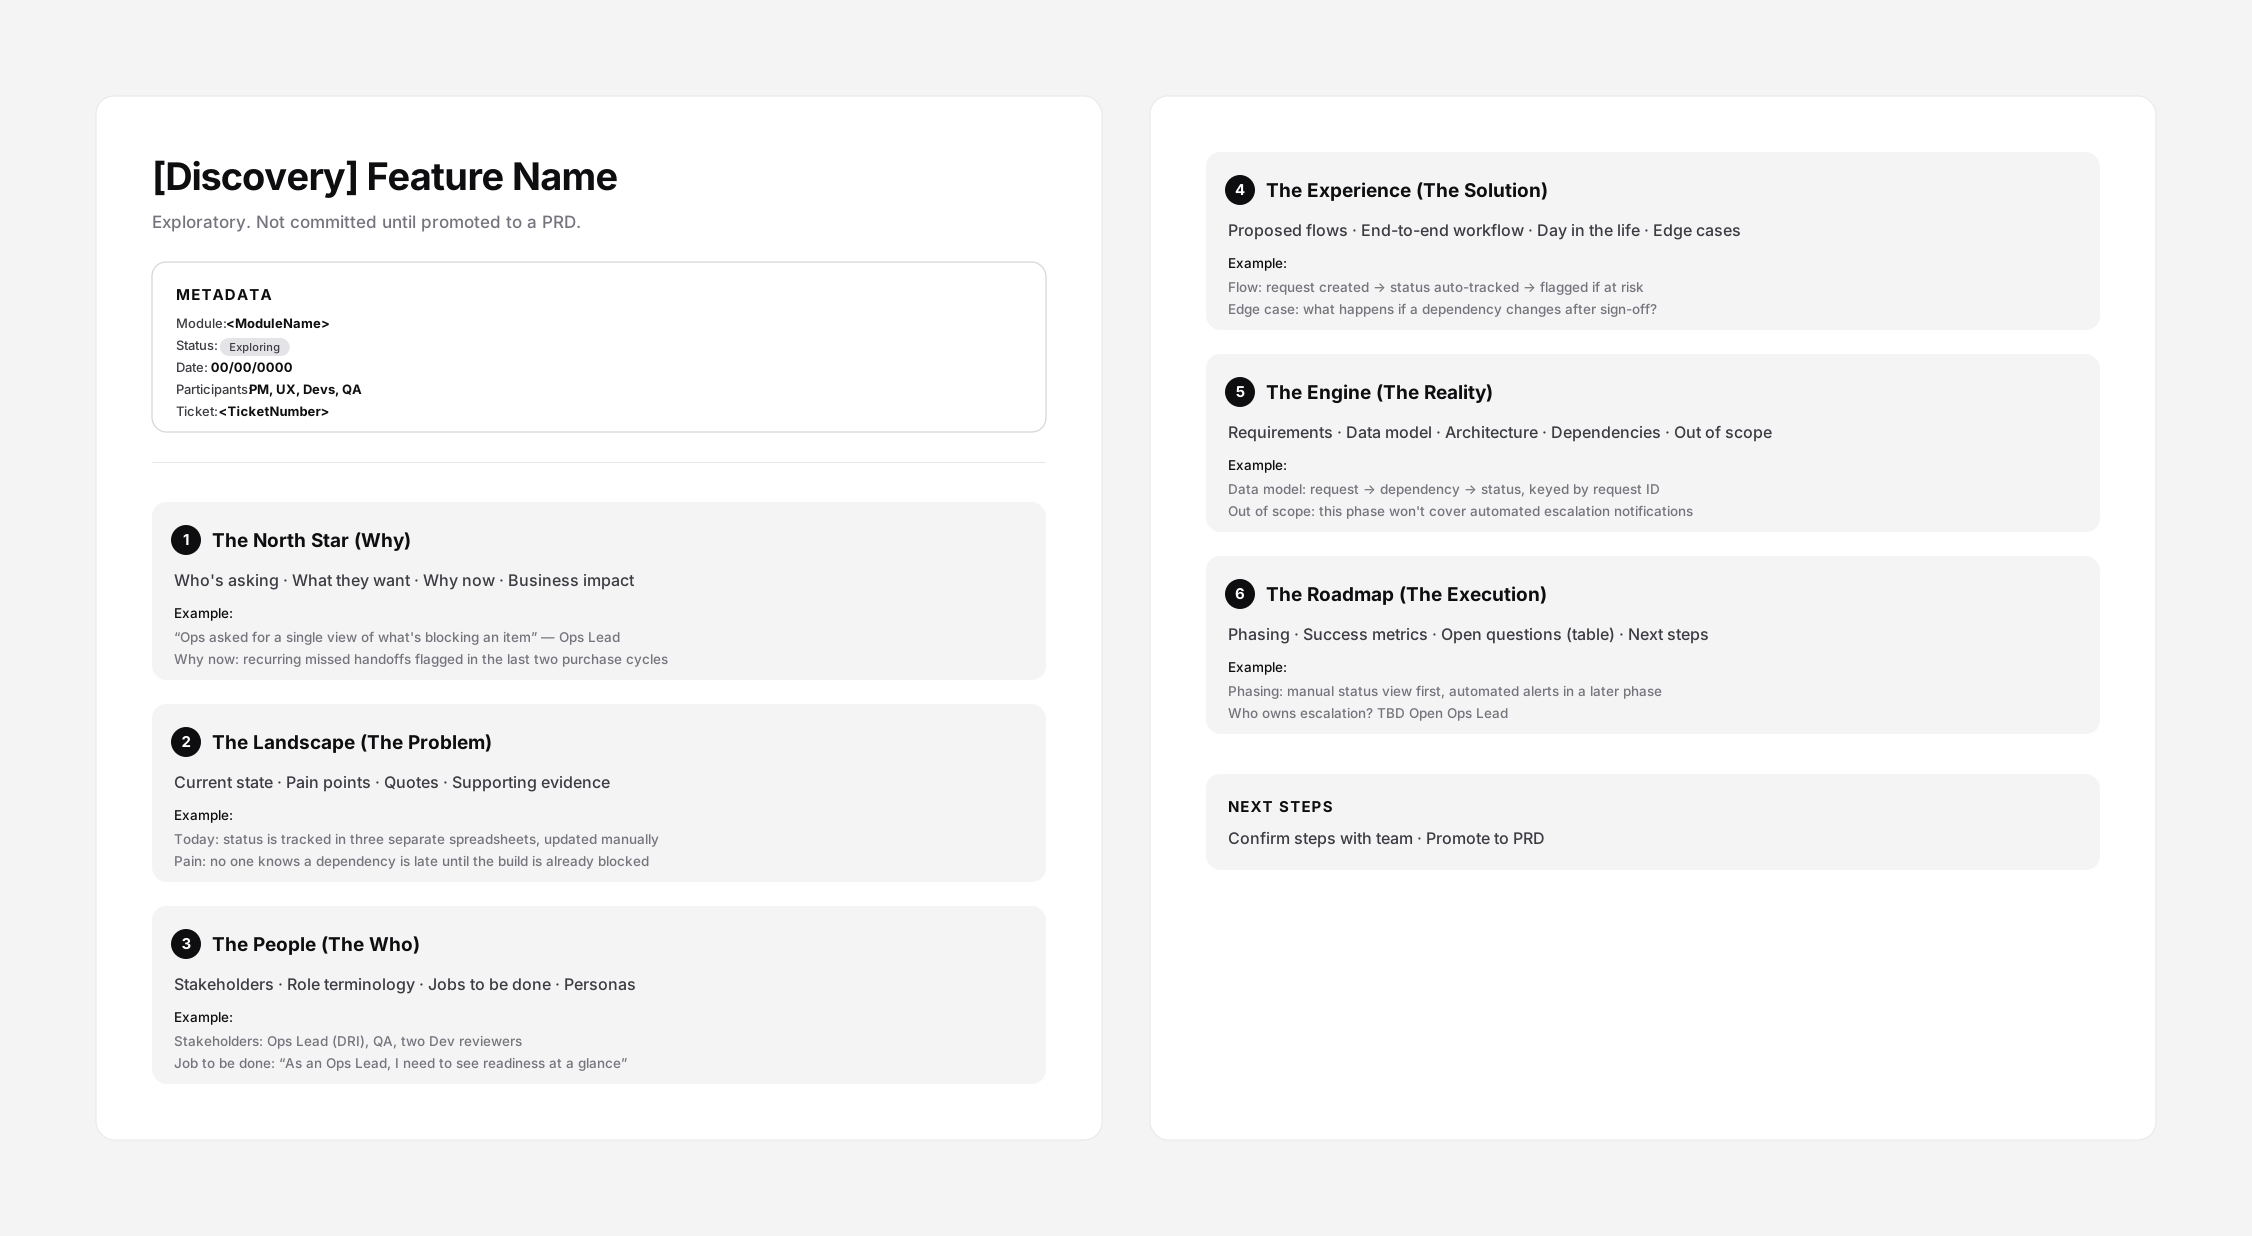
- Metadados trazem módulo, status, participantes e data.
- The North Star (o porquê) mostra quem está pedindo, o que quer, por que agora e o impacto no negócio.
- The Landscape (o problema) cobre como funciona hoje, as dores e as evidências tiradas da base de conhecimento.
- The People (quem) cobre stakeholders, papéis e o que cada usuário está de fato tentando fazer.
- The Experience (a solução) cobre os fluxos propostos, o fluxo de ponta a ponta e os casos de borda.
- The Engine (a realidade) cobre requisitos, modelo de dados, arquitetura, dependências e o que está fora do escopo.
- The Roadmap (a execução) cobre as fases, as métricas de sucesso, as perguntas em aberto com responsáveis e os próximos passos.
Como é construído sobre uma base de conhecimento versionada e fica no mesmo repositório que todo o resto, isso transformou semanas de pesquisa em um primeiro rascunho sólido, em uma fração do tempo, deixando mais espaço para as partes que realmente precisam de julgamento humano.
Testando em uma funcionalidade real
Apliquei isso em um discovery real, em andamento, de uma funcionalidade para acompanhar se os itens pedidos pelos times realmente chegam ao escritório antes de começar o ciclo de produção que precisa deles. O NovaFlow já acompanha essa demanda, então o pedido era acompanhar também a prontidão dos itens dentro do NovaFlow. A funcionalidade envolvia vários módulos do sistema, o que fez dela um bom teste de estresse para ver se o template e o rascunho gerado se sustentavam diante de stakeholders reais. Liderei o discovery, e o time do projeto revisou o que o processo gerou, comparando com o próprio conhecimento sobre o pedido antes de confiarmos nele como ponto de partida.
Como UX lead desse discovery, tratei o documento como algo vivo, e não como uma entrega pontual. Depois de cada reunião ou novo alinhamento, eu voltava e atualizava o documento diretamente: fechando perguntas em aberto, ajustando o escopo e registrando decisões na hora em que aconteciam. Isso manteve o documento como a verdadeira fonte de verdade do time, em vez de deixar as decisões espalhadas pela memória das pessoas e por anotações de reunião.
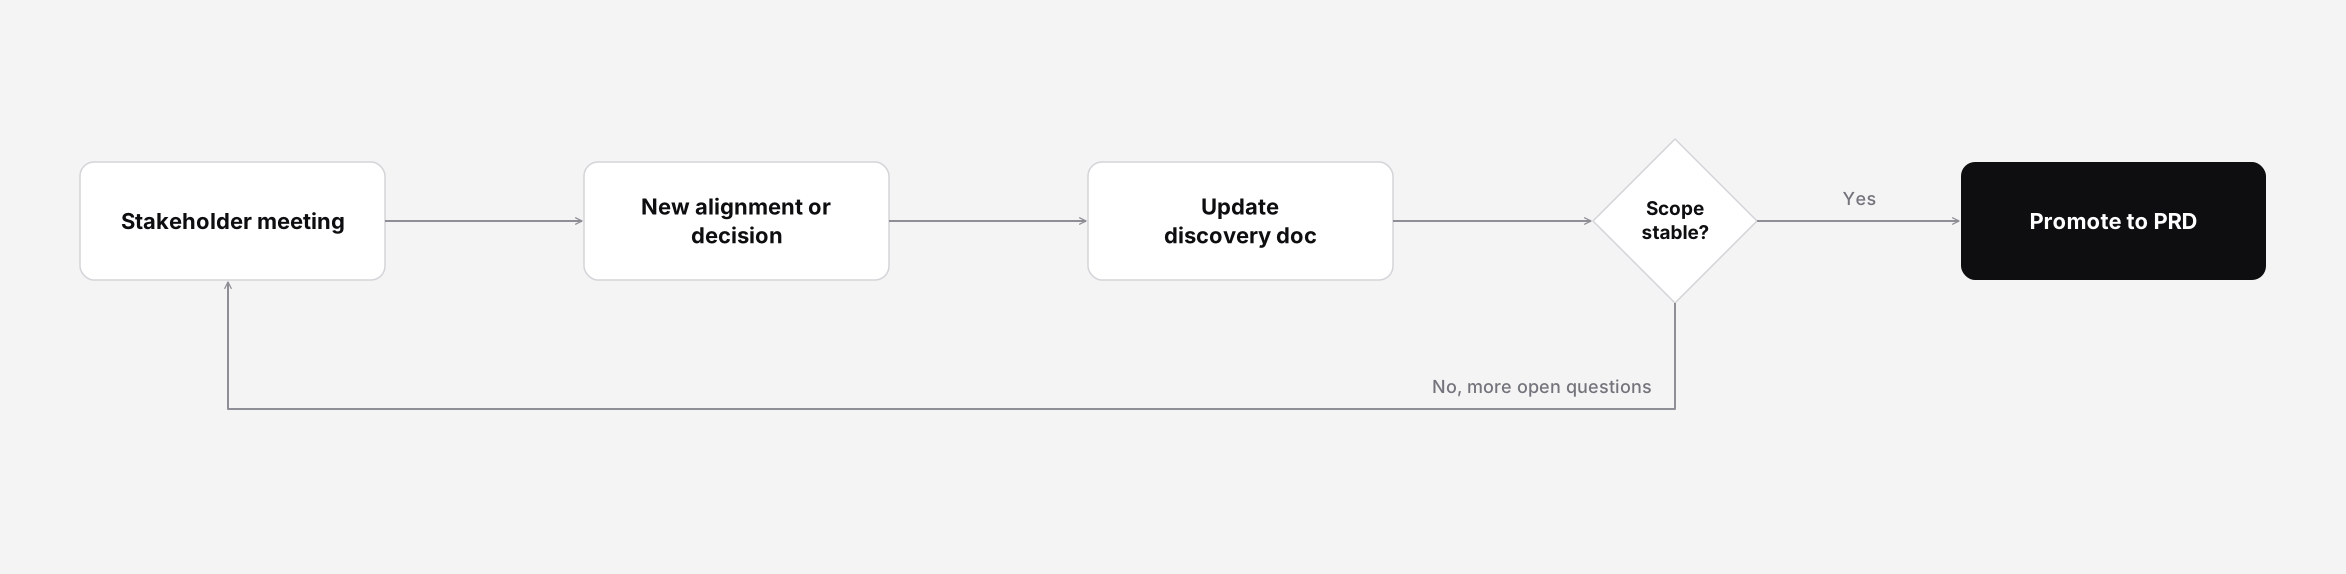
Quando o documento de discovery fica completo e é promovido a PRD (Product Requirements Document), ele deve dar a UX, QA e Dev um ponto de partida comum e validado para construir a funcionalidade, em vez de cada time montar sozinho o seu entendimento do que é necessário.
Visualizando a solução
O discovery ficou focado em perguntas, contexto e evidências, não em um design finalizado. Com o documento do Readiness Tracker pronto, eu tinha uma visão clara o bastante para esboçar um protótipo, como o abaixo.